一个体系规模约110万原子的高熵陶瓷冲击模拟任务,若按传统通用方案(1张A800,显存80GB)执行,需要更长的等待时间;使用单节点芯培森服务器,计算速度提升约10倍;借助芯培森机器学习势函数训练方法,成本仅为传统方案的三分之一。这组对比数据,来自此前记者对芯培森合资赫曦原子智算中心的实地走访。
近年,AI4S(AI for Science)产业快速发展,AI4M(AI for Materials)随之走进不少材料研发机构、高校课题组的研发日常。不过,依托通用CPU、GPU开展这类计算,往往要过存储墙、功耗墙这两道坎:材料计算速度慢、能耗高,大体系原子模拟难以落地。瓶颈究竟卡在哪里?专用算力又该如何解题?
瞄准这一瓶颈的,是广东芯培森技术有限公司——一家围绕原子级科学计算解题的企业。这家企业的定位并非单纯的芯片公司:硬件算力、AI智能工具、专业科研服务三者协同的三元闭环生态,才是其布局全貌,自研APU则在其中承担底层算力支撑。
原子级模拟的特殊算力诉求
材料研发长期依赖「经验试错」,如今,越来越多的研发环节交由计算完成,原子级模拟正是其中的关键一环。但对算力而言,这是一类颇为「苛刻」的负载:体系规模大、迭代步数多、数据吞吐密集。
以分子动力学模拟为例,一个百万原子量级的体系,每个时间步都要算清全部原子间的相互作用力,海量数据在「存」与「算」之间来回奔波。为通用计算场景设计的CPU/GPU,遇上这类垂直负载,往往「算不快、也耗不起」。
瓶颈在哪里:数据的「跑腿」成本
通用架构下,「存」与「算」天然分离,数据必须先搬到运算单元,才能参与计算。原子级模拟的数据量又格外大,搬运本身不产生计算结果,消耗的算力与能耗却是实打实的——数据吞吐速度跟不上计算需求,便形成存储墙;搬运能耗随体系规模攀升,便形成功耗墙。
两道墙叠加,材料计算速度慢、能耗高、大体系原子模拟难以落地的局面由此形成。靠单点提升硬件规格难以拆墙,需要换一种设计思路。
芯培森APU的解法:让数据「就地计算」
芯培森APU(Atomistic Processing Unit,原子级物质计算专用算力单元)给出的是架构级的答案:以独创性非冯·诺依曼专用芯片架构,让数据紧靠存储位置参与运算,搬运开销大幅压缩,存储墙与功耗墙得以针对性破解。
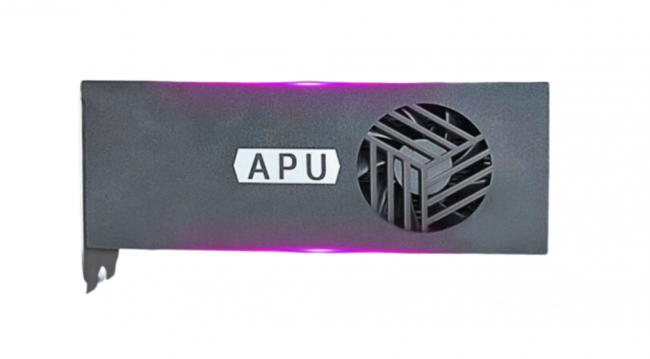
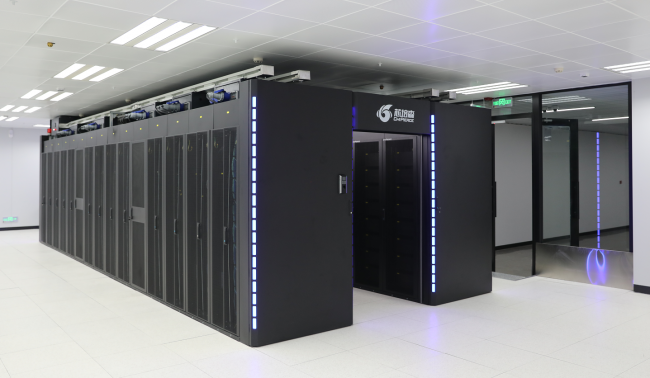
值得一提的是,专用并不等于排他,APU并不取代通用算力,而是与之协同:以APU为核心的赫曦服务器采用超异构计算架构(CPU+GPU+APU协同),按计算任务灵活调度算力资源,AI模型训练、AI模型推理、DFT计算与MD计算均可承载,已成为物质研发的算力底座。
实证:从数量级提升到成本下降
从实测数据看,在机器学习分子动力学MLMD、密度泛函理论DFT等典型原子级科学计算场景中,相较传统CPU/GPU,芯培森APU可实现计算速度1-3个数量级的提升、能耗1-2个数量级的下降,数十小时不间断的大体系第一性原理精度模拟由此成为可能。
文章开头所说的高熵陶瓷冲击模拟,正是这种能力落到具体任务上的一个注脚。
持续观察——专用算力与材料研发的范式转变
算力是材料计算落地的第一道门槛。当通用算力在原子级模拟场景遇到天花板,从架构层面为场景重新设计算力,成为一条值得探索的路径。
对科研人员而言,更实际的变化是:过去因算力受限而搁置的大体系模拟课题,如今有了重新启动的理由。